AlphaNet 기술 백서: 자동 거래 시스템 아키텍처
AI 퀀트 트레이딩, 딥 러닝, 위험 제어 및 알고리즘 실행
이 기술 백서는 AlphaNet에 대해 설명합니다. 자동 거래 시스템 아키텍처: AI 양적거래 프레임워크는 AI DEX, 고차원 알파 생성, 딥 러닝 모델, 과적합 제어, 시장 시장 국면 적응 및 알고리즘 주문 실행.
A. 연구 배경: 거래 우위의 격차
I. 소매 거래 우위 적출
AlphaNet가 무엇인지, AI DEX가 무엇을 해결하려고 하는지 알아보기 전에 동기의 개요를 살펴봐야 합니다.
암호화폐 시장의 진화는 비효율적이고 소매업이 지배하는 "와일드 웨스트(Wild West)"에서 매우 정교하고 제도화된 금융 전쟁터로 전환되었습니다. 진입 장벽이 낮아 접근성이 좋은 반면, 수익성 장벽은 기하급수적으로 높아졌습니다. 제로섬 게임(수수료 차감 후 마이너스섬)에서는 일반적으로 자신이 이기려면 다른 사람이 패해야 합니다. 다음은 가치 추출을 도박이 아닌 과학으로 취급하는 시장 참여자에 비해 소매 거래자가 구조적으로 불리한 이유를 자세히 설명하는 주장입니다.
1. 정보 비대칭("뉴스" 격차)
소매 거래자는 일반적으로 다음과 같이 운영됩니다. 지연 정보, 기관은 다음과 같이 운영되는 반면 선행 지표 및 권한 있는 액세스.
소매 피드: 내러티브가 Twitter(X), Telegram 또는 뉴스 매체에 도달할 때쯤에는 일반적으로 가격 변동이 이미 발생한 것입니다. 소매점은 종종 몇 주 전에 구매한 내부자에게 "출구 유동성"이 됩니다.
기관 피드:
대체 데이터: 헤지 펀드는 개발자 활동을 위해 GitHub 저장소를 긁어내고, 독점 소프트웨어(Chainalytic/Nansen Enterprise)를 통해 지갑 연결을 추적하고, 추세 추세가 나타나기 전에 NLP(자연어 처리) 알고리즘을 사용하여 사회적 감정을 모니터링합니다.
내부자 액세스: VC와 시장 조성자는 프로토콜 창립자와 직접 연결되는 경우가 많습니다. 그들은 공개되기 전에 잠금 해제 일정, 지연 또는 파트너십에 대해 알고 있습니다.
2. 기술적 틈(속도 및 실행)
거래 시간이 짧은 트레이더(스캘퍼/일 트레이더)의 경우 속도, 실행 및 단기 데이터 처리가 중요한 유일한 지표입니다. 리테일은 나무막대기를 들고 기관총을 상대로 전쟁을 벌이고 있습니다.
대기 시간 및 공동 위치
소매: 웹 인터페이스 또는 모바일 앱에서 "구매"를 클릭합니다. 귀하의 요청은 표준 인터넷을 통해 거래소 서버로 이동합니다.
HFT(고주파 거래자): 그들은 사용합니다 공동 배치. 해당 서버는 거래소의 매칭 엔진과 동일한 클라우드 클러스터 또는 데이터 센터에 물리적으로 위치합니다. 그들은 본다 주문서 가 업데이트되기 전에 업데이트됩니다. 그 위에 추가 거래 우위에 있는 대기 시간이 짧은 기계 학습 예측 알고리듬과 알고리즘 실행 레이어입니다.
MEV(최대 추출 가능 값)
분산형 거래소(DEX)에서 소매업은 끊임없이 봇에 의해 앞지르게 됩니다.
- 샌드위치 공격: 미끄러짐 허용 범위가 높은 대규모 구매 주문을 하면 봇이 "mempool"(거래 대기 영역)에서 이를 감지합니다. 봇은 사용자 바로 앞에서 구매하고(가격 인상), 구매 주문을 실행한 다음(가격 추가 인상), 사용자 직후에 판매합니다. 당신은 더 나쁜 가격을 얻습니다. 그들은 위험 없이 이익을 얻습니다.
3. 수수료와 유동성의 함정
소매업의 경우 비즈니스 수행 비용이 상당히 높기 때문에 시간이 지남에 따라 우위가 약화됩니다.
| 기능 | 소매 상인 | 마켓 메이커 / VIP Fund |
|---|---|---|
| 거래 수수료 | 거래자당 ~0.03%~0.10%, ~0.07~0.03을 지불합니다. 메이커 | 종종 지불 0% 또는 지급을 받음 리베이트 (메이커 리베이트) 유동성을 제공합니다. |
| 펀딩 요율 | 종종 레버리지 포지션을 유지하기 위해 자금을 지불합니다. | 현물 대 선물(현금 및 캐리)을 헤징하여 자금을 모으는 경우가 많습니다. |
| 미끄러짐 | 실행에 큰 영향을 미칩니다(입출금 자금 손실). | 정교한 실행 알고리즘(TWAP/VWAP)으로 영향을 최소화합니다. |
파멸의 수학: 작은 승리를 목표로 하는 소매 스캘퍼는 엄청난 장애물(수수료 + 스프레드)을 극복해야 합니다. 수수료를 전혀 지불하지 않는 기관은 가격 변동으로 인해 이익을 얻을 수 있으며 이는 소매업에 순손실이 될 수 있습니다.
4. 알고리즘 포식 및 시장 구조
기관은 단지 시장을 예측하는 것이 아닙니다. 그들은 소매 행동을 촉발하도록 그것을 구성합니다.
퀀트 모델: 정량적 펀드는 통계적 차익거래와 평균회귀 모델을 사용합니다. 그들은 "기술"이나 "커뮤니티"에 관심이 없습니다. 코인이 비트코인이나 이더리움과의 상관관계에서 수학적으로 벗어나면 재정렬될 때까지 즉시 매도/매도합니다. 그들은 채굴 알파를 효율적이고 확장 가능하게 만드는 최고의 재능, 충분한 컴퓨팅 및 축적된 기술을 보유하고 있습니다.
사냥 중지: 고래와 알고리즘은 "유동성 클러스터"(소매 거래자가 손절매를 배치하는 위치)를 볼 수 있습니다. 그들은 일시적으로 가격을 이 영역으로 밀어 넣어 강제 매도(청산)를 촉발하고 가격이 반전되기 전에 값싼 유동성을 흡수할 수 있습니다.
워시 트레이딩: 규제되지 않은 거래소나 소액 코인에서는 소매업체가 유기적 이익(FOMO)이 있다고 생각하도록 유인하기 위해 거래량을 위조하는 경우가 많습니다.
5. 심리적 단점
아마도 기관이 가지고 있는 가장 큰 이점은 인간의 감정을 제거하는 것입니다.
소매: FOMO(Fear Of Missing Out), FUD(Fear, Uncertainty, Doubt), 복수 거래 및 매몰 비용 오류에 취약합니다. 소매업자들은 종종 승자를 조기에 잘라내고 패자를 놔두는 경우가 많습니다.
알고리즘: Python 스크립트에는 세로토닌이나 도파민이 없습니다. 엄격한 논리를 바탕으로 실행됩니다. 거래가 무효화되면 즉시 취소됩니다. 설정이 없으면 거래가 되지 않습니다.
거래 기간별 우위 비교
스캘핑(초/분): 소매 거래 우위: 거의 0%. HFT 대기 시간 및 수수료 구조를 이길 수 없습니다.
스윙 트레이딩(일/주): 소매 우위: 낮음. 레버리지를 청산하기 위해 고안된 "심지"에 취약하지만 스캘핑보다 더 나은 기회가 있습니다. 높은 구경의 정량 모델의 체계적인 일관성과 견고성이 없습니다.
투자(월/년): 소매 우위: 보통. 이것은 소매업이 싸울 기회가 있는 유일한 영역입니다. 헤지펀드의 월별 보고 요건보다 긴 기간을 가짐으로써 소매업체는 펀드의 위험을 제거할 수 있는 변동성을 극복할 수 있습니다.
요약
이 차이는 실력뿐 아니라 자원과 거래 환경의 구조적인 차이에서 비롯됩니다.
정보: 그들은 당신보다 먼저 당신보다 더 많은 것을 알고 있습니다.
속도: 그들은 당신보다 먼저 행동합니다.
비용: 그들은 거래에 대해 더 적은 비용을 지불하거나 지불을 받습니다.
알파: 더 나은 모델, 더 나은 알고리즘, 독점 노하우.
자본금: 분산을 흡수할 수 있는 깊이가 있습니다. 당신은하지 않습니다.
II. 제도적 이점 – 참가자의 심층 살펴보기
계속 읽으면서 곧 알게 되겠지만, AlphaNet AI DEX의 목표는 사용자에게 기관 플레이어와 동일한 수준의 에지에 대한 액세스를 제공하는 것입니다. 따라서 먼저 소매 거래자가 상대하는 시장 참가자 유형에 대해 자세히 살펴보겠습니다.
소매업자가 직면하는 구조적 단점은 단지 "기술"에 관한 것이 아닙니다. 그것은 약이다 접근성, 인프라, 축적된 노하우 및 비용 기반. 다음은 4개의 주요 기관 참가자가 보유한 특정 우위에 대한 구조화된 요약입니다.
1. HFT 시장 조성자("속도 및 비용" 우위)
이러한 회사(예: Wintermute, Jump Trading)는 거래소에 유동성을 제공합니다. 그들은 가격 방향에 베팅하지 않습니다. 그들은 스프레드에 돈을 걸었습니다.
제로 또는 마이너스 수수료(리베이트):
소매: 거래당 ~0.05% - 0.1%(테이커 수수료)를 지불합니다. 손익분기점에 도달하려면 가격이 최소한 해당 금액만큼 유리하게 움직여야 합니다.
거래 우위: HFT는 종종 비용을 지불합니다. -0.01% ~ -0.02%(메이커 리베이트). 거래소는 지정가 주문을 하기 위해 수수료를 지불합니다. 그들은 비트코인을 $95,000에 구매하고 $95,000에 팔아도 여전히 수수료 리베이트만으로 이익을 얻을 수 있습니다. 소매업체는 동일한 거래에서 돈을 잃습니다.
공동 위치(대기 시간):
소매: 귀하의 주문은 표준 광섬유 케이블을 통해 집/사무실에서 교환 서버로 이동합니다(50-200밀리초).
거래 우위: HFT 서버는 거래소의 매칭 엔진(교차 연결)과 동일한 위치에 물리적으로 위치하는 경우가 많습니다. 그들은 시장 데이터를 수신하고 거래를 실행합니다. 마이크로초. Binance에서 가격이 움직이면 화면이 새로 고쳐지기 전에 Coinbase에서 가격을 차익거래할 수 있습니다.
주문장 가시성:
- 거래 우위: 그들은 독점 알고리즘을 사용하여 "빙산 주문"(소규모 주문으로 숨겨진 대량 주문)을 감지하고 주문서를 "스푸핑"합니다(가짜 구매 벽을 배치하여 소매업체를 구매하도록 유도한 후 즉시 취소).
2. 퀀트 펀드("데이터 및 확률" 엣지)
이 펀드는 기계 학습과 수학적 모델을 사용하여 인간의 눈에 보이지 않는 비효율성을 찾아냅니다. 현재 많은 사람들이 딥 러닝 + AI를 사용하여 우위를 점하고 있습니다.
통계 차익거래(Stat Arb):
소매: "머리와 어깨" 또는 "지원 수준"과 같은 패턴을 찾습니다.
거래 우위: Quants는 수천 개의 코인 쌍의 상관관계를 동시에 추적합니다. 간단한 예: BTC가 1% 움직일 때 ETH는 일반적으로 2% 움직이지만 오늘은 1.8%만 움직인다면, 그들의 봇은 수학적으로 평균으로 되돌아갈 것이라는 것을 알고 즉시 0.2% 편차를 구매합니다. 그들은 확률이 51%인 수천 개의 작은 거래에서 승리합니다.
체계적인 방향성 거래(추세 추종 포함)
소매: 추세가 뚜렷해지면 따르다가 상대적으로 효율적인 시장으로 인해 쉽게 "속임수"됩니다.
거래 우위: Quants는 비선형 논리에서 수백 개가 넘는 데이터 포인트를 고려하여 가장 정교한 전문 소매 거래자조차도 생성할 수 없는 수익성 있는 신호를 생성하는 모델을 구축할 수 있습니다.
대체 데이터 파이프라인:
소매: 뉴스 헤드라인이나 공개 차트에 의존합니다.
거래 우위: Quant 자금은 값비싼 "대체 데이터" 피드 비용을 지불합니다.
위성 이미지: 채굴 센터의 에너지 사용량을 모니터링합니다.
지갑 추적: 특정 "스마트 머니" 지갑이 자금을 이동할 때 실시간 경고를 제공합니다.
감정 분석: Twitter/Telegram/Discord를 긁어 "과장 광고" 및 선두 소매 FOMO를 정량화하는 NLP(자연어 처리) 봇입니다.
3. 고래("자본 및 심리학" 거래 우위)
가격 조치를 지시할 만큼 충분한 공급을 보유하고 있는 순자산 가치가 높은 개인 또는 단체입니다.
사냥 중지(유동성 수확):
소매: 논리적 손절매를 지원 수준 아래에 배치합니다.
거래 우위: 고래는 "유동성 클러스터"(수천 개의 소매점이 있는 구역)를 볼 수 있습니다. 그들은 자본을 사용하여 공격적으로 판매하고, 귀하의 정지를 유발할 수 있을 만큼 가격을 낮게 책정합니다(귀하가 판매하도록 강요함). 그런 다음 그들은 더 저렴한 코인을 다시 사서 유동성을 흡수하여 다음 단계에 연료를 공급합니다.
비용 기반 이점:
- 거래 우위: 고래는 종종 수년 전에 또는 OTC(Over-The-Counter) 데스크를 통해 포지션을 축적했습니다. 그들은 공개 현물 시장에서 구매하지 않기 때문에 대량 구매를 해도 가격이 즉시 오르지 않습니다.
시장 이동:
- 거래 우위: 유동성이 낮은 코인에서는 고래가 간단히 "차트를 칠"할 수 있습니다. 그들은 자신의 판매 주문(워시 트레이딩)을 구매하여 대량 판매라는 환상을 만들어 소매 추세를 따르는 봇과 트레이더가 진입하도록 속일 수 있습니다.
4. 정보 내부자("시간 여행" 에지)
VC, Exchange 직원 및 프로토콜 창립자.
프라이빗 라운드 액세스:
소매: "공개 출시" 가격(예: $1.00)으로 토큰을 구매합니다.
거래 우위: 내부자는 몇 달 전에 SAFT(미래 토큰에 대한 단순 계약)를 통해 $0.05 또는 $0.10에 구매했습니다. 토큰이 출시 후 80% 하락하더라도 여전히 200% 상승합니다. 이는 귀하가 막대한 손실을 입는 동안에도 수익성 있게 귀하에게 투매할 수 있음을 의미합니다.
잠금 해제 일정 확인:
- 거래 우위: 내부자는 정확히 두 번째 수백만 개의 잠긴 토큰이 귀속되고 거래 가능하게 될 것임을 알고 있습니다. 그들은 잠금 해제가 시장에 넘쳐나기 전에 짧은 포지션을 개설하거나 유동 지분을 판매함으로써 이러한 인플레이션을 미리 실행할 수 있습니다.
거래소 상장 알파:
- 거래 우위: Tier 1 거래소(Binance/Coinbase)에 상장되면 일반적으로 토큰이 펌핑됩니다. 내부자는 NDA 시도에도 불구하고 이러한 상장에 대해 몇 주 전에 미리 알고 발표가 있기 전에 분산형 거래소(DEX)에 토큰을 축적하는 경우가 많습니다.
거래 우위 요약
| 참가자 | 주요 강점 | 소매업체가 경쟁할 수 있나요? |
|---|---|---|
| HFT | 속도 및 리베이트 (마이너스 수수료) | 아니요. 물리학이나 마이너스 비용을 이길 수는 없습니다. |
| 퀀트 | 데이터, 모델 및 기계 (확률) | 아니요. 그렇게 많은 데이터를 수동으로 처리하고, 많은 모델을 훈련하고, 체계적인 파이프라인을 강력하게 갖출 수는 없습니다. |
| 고래 | 캐피탈 (시장 이동) | 아니요. 변동성을 흡수할 자금이 부족합니다. |
| 내부자 | 정보 (미래를 아는 것) | 아니요. 당신은 법적/구조적으로 서클 밖에 있습니다. |
B. AlphaNet AI DEX: 자동화된 암호화폐 거래 시스템
이제 소매 거래자와 전문 개인 거래자가 독특한 최첨단 기술에 접근할 수 있다면 어떨까요? 정량적 AI 플랫폼, 역학은 "집에 대한 도박"에서 "대응 전략 사용"으로 전환됩니다. 소매 및 개인 전문 거래자는 물리적으로 HFT 시장 조성자의 속도나 창업자의 내부 지식(액세스)을 이길 수 없지만 AI 플랫폼은 다음 문제를 해결하여 경쟁의 장을 평준화합니다. 실행 및 데이터 처리, 독점 모델 및 시스템, 컴퓨팅 리소스 간격.
이 섹션에서는 다음을 제공합니다. 일반인도 가능한 요약 AlphaNet가 거래자의 알파 및 거래 우위를 제공하고 변화시키는 방법 – 갈망하는 사람들을 위해 기술 심층 분석, 다음 섹션을 읽어보세요.
I. 약점 제거
정량적 AI 거래 플랫폼은 세 가지 가장 큰 소매 약점을 제거합니다.
처리 능력: 인간은 몇 가지 차트를 보고 자신이 좋아하는 지표, 뉴스피드 및 온체인 분석을 사용할 수 있습니다. 지연 시간이 짧은 강력한 기계 학습 파이프라인은 모델에 따라 초당 수백 또는 수천 개의 데이터 포인트를 사용하여 처리하고 예측할 수 있습니다.
감정: 이러한 시스템은 결코 희망 때문에 "복수 거래"를 하거나 "패자를 보유"하지 않습니다. 신호, 위험 모델 및 모델이 결정한 종료 임계값에 따라 논리를 무자비하게 실행합니다.
실행 기술 및 속도: 목표는 HFT 시장 조성자와 속도를 맞추는 것이 아니지만, 강력한 딥 러닝 기반 실행 알고리즘은 "상위 주문"을 분류하고 거래를 밀리초(100~300ms) 단위로 분할하여 슬리피지 및 거래 비용을 최소화하는 데 도움이 됩니다. (AI 시스템 섹션에서 자세한 기술 정보)
이 백서의 다음 섹션에서는 왜 지금까지 인기 있는 생성 AI(LLM)가 아닌 딥 러닝을 AI라고 부르는지 설명합니다.
II. 딥 러닝 시스템: 제도적 힘, 소매 통제
딥 러닝 시스템과 체계적인 알파 마이닝에 대한 연구 비교를 보려면 다음을 읽어보세요. 알고리즘 트레이딩과 체계적인 알파 마이닝을 위한 딥 러닝.
아래에서는 AlphaNet가 핵심 제품 및 설계 원칙을 통해 거래자에게 우위를 제공, 최적화 및 유지하는 방법에 대한 기본 아이디어를 제공합니다.
1. "뇌": 딥 러닝 및 다중 요소 분석
대부분의 기존 자동 거래 플랫폼이 기술 지표를 통해 선형 규칙을 따르는 간단한 거래 봇("가격이 이동 평균을 넘으면 매수"). AlphaNet는 딥 러닝(DL) 모델은 수년간의 세분화된 과거 데이터를 학습하고 실시간 데이터를 추론합니다.
단일 차트를 보는 대신 AI가 평가합니다. 수백 또는 수천 가지 요소(기능) 를 실시간으로 사용하여 미래 가격 행동에 대한 확률 지도를 구축합니다.
입력 레이어(데이터):
시장 데이터: 가격, 거래량, 추가 정보(변동성, 범위, 추세, 패턴, 엔트로피 등)를 제공하는 가격 및 거래량 파생
시장 미세구조: 주문장 불균형, 매수-매도 확산 속도, 거래 규모 클러스터.
파생상품 데이터: 펀딩 비율 이상, 미결제약정 변경, 청산 히트맵.
상호상관: BTC가 ETH, 스테이블코인 지배력 및 레거시 시장 상관관계(SPX/NDX)와 관련하여 움직이는 방식입니다.
온체인 신호: 거래소 유입/유출, 고래 지갑 활성화.
출력: AI는 "추측"하지 않습니다. 신뢰도 점수를 할당합니다(예: 다음 4개 블록에서 상향 변동 확률 84.2%) 또는 이러한 수백 가지 요인이 비선형적으로 상호 작용하는 방식을 기반으로 한 수익 예측(일반적으로 특정 기간(15개월, 1시간, 2시간 등)의 가격 로그[수익률])입니다.
2. 전략: 고차원 알파
기본 엔진은 딥 러닝을 사용하기 때문에 특정 DL 버전의 전략은 임의 소매 접근 방식이나 상업용 "거래 봇"의 전략보다 훨씬 더 강력합니다.
마이크로트렌드 전략
기간: 평균 몇 시간에서 며칠까지
목표: 비용을 충당하고 수익을 창출할 수 있을 만큼 오래 지속되지만 매크로 투자자가 몰아내기에는 너무 짧은 지속적인 움직임(추세)을 포착합니다.
전통적인 결함: 기술 지표가 "지연"되어 있습니다. 그들은 가격이 이미 크게 움직인 후에만 추세가 시작되었음을 알려줍니다. 늦게 들어가고 늦게 나가서 여백을 먹습니다.
딥 러닝 최적화:
특징 추출: 가격 대신 DL 모델(예: AlphaNet에서 사용되는 LSTM 또는 Transformer)은 가격, 거래량, 주문서 불균형 및 잠재적인 대체 데이터(전략에 따라 다름)를 동시에 수집합니다.2
시퀀스 모델링: 이동 평균이 교차하기 전에 추세 형성의 "모양"을 인식하기 위해 최근 데이터의 전체 시퀀스를 살펴봅니다.
거래 우위 개선: 빠른 진입과 거짓 돌파 필터링.
- 간단한 설명: 전통적인 거래자는 "승인 신호" 신호를 기다립니다. DL 모델은 녹색 신호가 나타날 때까지 긴장이 고조되는 것을 보는 패턴 매칭 전문가처럼 행동합니다. 이동 평균보다 3-4 캔들 먼저 추세에 진입할 수 있으며, 결정적으로 단순한 지표로는 놓칠 수 있는 수백 개의 데이터 포인트를 비선형 방식으로 연관시켜 실제 추세 시작과 "가짜"를 구별할 수 있습니다.
단일 자산 평균 회귀
기간: 30분 ~ 몇 시간
목표: 가격이 특정 평균 지점으로 되돌아갈 것이라는 데 베팅합니다.
전통적인 결함: 전통적인 평균 회귀는 고정 밴드(예: 볼린저 밴드)와 같은 접근 방식을 사용합니다.4 강력한 붕괴(추세 시장)에서는 가격이 밴드를 끌어안고 계속 하락합니다. 전통적인 전략은 계속해서 하락세를 매수하다가 전멸됩니다("떨어지는 칼을 잡는 것").
딥 러닝 최적화:
시장 국면 분류: DL 모델(종종 CNN 또는 MLP)에는 시장 시장 국면를 분류하는 사전 모델 계층이 있습니다. "우리는 절단하고 있습니까?" 또는 "우리 충돌하고 있나요?"5
동적 임계값: 시장 국면 계층이 "Crash Regime"을 감지하면 가격이 낮더라도 DL 모델이 출력하는 구매 신호를 비활성화합니다. 변동성이 안정화되고 있음을 감지한 경우에만 평균 회귀가 가능합니다. 이를 "동적 거래 규칙"이라고 합니다(다음 섹션에서 자세히 다룹니다).
거래 우위 개선: 위험 관리와 지속 가능한 거래.
- 간단한 설명: 전통적인 평균 회귀는 고무줄과 같습니다. 당신은 그것이 다시 스냅 될 것이라고 확신합니다. 그러나 때로는 고무줄이 끊어지는 경우도 있습니다(시장 붕괴). 딥러닝은 고무줄이 끊어질지 여부를 확인하는 센서 역할을 합니다. 그렇다면 거래하지 말라고 합니다. 장점은 단순히 돈을 버는 것이 아닙니다. 그것은 당신의 한 달을 망치는 나쁜 거래를 피하는 것입니다.
AI 레버리지 스캘핑
기간: 10~30분
목표: 레버리지를 사용하여 이익을 증폭시켜 일중 작은 움직임으로 빠른 이익을 얻습니다.
전통적인 결함: 표준 스캘핑 모델 또는 알고스는 "프레임"(예: 1초마다)으로 데이터를 처리합니다. 이로 인해 지연(프레임이 닫힐 때까지 대기)과 계산 노이즈(아무 일도 일어나지 않는 경우에도 데이터 처리)라는 두 가지 문제가 발생합니다.
스파이킹 신경망(SNN) 최적화:
이벤트 기반: AI 스캘핑 전략을 활용하기 위해 AlphaNet는 주로 SNN(스파이킹 신경망) 구현을 사용합니다. SNN은 "시간 표시줄"이 닫힐 때까지 기다리지 않습니다. 특정 가격 변화(이벤트)가 발생할 때만 "실행"(활성화)됩니다.
시장 노이즈 억제: 시장이 조용하면 SNN도 조용합니다. 이는 대량의 정보에만 반응합니다.
거래 우위 개선: 고빈도 거래 인프라 없이도 실행 속도와 정확도 향상
간단한 설명: 카메라를 감시하는 경비원을 상상해 보십시오.
기존 시스템: 1초마다 화면을 봅니다. 도둑이 0.5초 안에 지나가면 AI가 이를 놓치거나 흐릿하게 보일 수 있습니다.
SNN: 모션 센서에 연결됩니다. 픽셀이 변경되는 순간에 반응합니다.
소매 거래자에게 이는 시스템이 표준 캔들 기반 시스템보다 훨씬 빠르게 갑작스러운 변동성 스파이크(진입 또는 비상 퇴출)에 반응하여 레버리지 포지션을 갑작스러운 미끄러짐으로부터 보호할 수 있음을 의미합니다.
3. 기계 학습 통찰력 모델
대부분의 소매 거래자들은 다음에 집착합니다. "신호" (매수/매도)이지만 많은 기관 거래자들이 이에 집착합니다. "컨텍스트" (시장 국면, 변동성, 유동성). 제공함으로써 비신호 상황별 통찰력, 모델은 다음과 같이 작동합니다. "시장 기상학자". 차를 어디로 운전해야 하는지는 알려주지 않지만(당신의 거래 스타일에 따라) 비가 오거나 눈이 오거나 맑은 날이면 알려주므로 어떤 타이어를 사용해야 할지, 얼마나 빨리 운전해야 하는지 알 수 있습니다.
AlphaNet가 트레이더에게 제공하는 ML 기반 통찰력의 주요 카테고리가 "Meta-Edge"를 생성하는 방법과 사용자가 이를 자신의 스타일과 결합할 수 있는 방법은 다음과 같습니다.
시장 국면 감지("지형" 지도)
문제: 당신은 추세 트레이더이지만 시장은 "찹"(횡방향) 시장 국면에 들어갑니다. 이동 평균 전략은 잘못된 돌파로 인해 망가졌습니다.
ML 솔루션:
기술: 용도 은닉 마르코프 모델(HMM), 비지도 학습 (예: K-Means)는 시장 상태를 개별 버킷(고 거래량 추세, 저 거래량 분쇄, 절단/노이즈, 청산 계단식)으로 분류합니다.
거래 우위: AI는 가격이 확인되기 전에 시장 국면 변화를 감지합니다. 예를 들어, 주문장 유동성이 줄어들고(변동성의 전조) 시장 국면 태그를 "안정적"에서 "취약함"으로 전환할 수 있습니다. 시장의 다양한 측면(추세, 구조적 변화, 변동성, 유동성, 거시적 등)을 측정하는 다양한 변형 시장 국면 모델이 있습니다.
사용자 이점: 최적의 거래 의사결정을 위해 구조적 변화를 활용하세요.
변동성 예측("속도 제한")
문제: 고정된 손절매(예: $100)를 사용합니다. 변동성이 낮으면 시장 노이즈으로 인해 중단됩니다. 변동성이 높으면 정지가 너무 빡빡합니다.
ML 솔루션:
기술: 용도 LSTM(장단기 기억) 네트워크는 가격 및 거래량 차이뿐만 아니라 옵션 흐름(내재된 변동성) 및 자금 조달 요율을 수집하여 미래 변동성(RV)을 예측합니다.
거래 우위: 더 나은 위험 조정 수익률. 모델은 다음과 같이 예측합니다. "변동성은 다음 시간에도 확대되거나 계속해서 높아질 것입니다."
사용자 이점: 포지션 크기를 동적으로 조정합니다. 거래량이 높으면 더 넓은 스톱으로 더 작은 크기를 거래합니다. 거래량이 낮으면 더 작은 크기로 더 큰 크기를 거래합니다.
다중 시간 지평선 추세 강도("바람" 게이지)
문제: 귀하는 거래 중이며 추세가 느려지고 있습니다. 일찍 나가면 더 높이 찢어지는 것을 볼 수 있습니다.
ML 솔루션:
기술: 용도 Transformer 모델 (GPT와 유사하지만 시계열의 경우) 시장의 "관심도"를 분석합니다. 추세의 "건전성"을 측정하기 위해 거래 속도와 거래 빈도를 살펴봅니다.
거래 우위: "반전"(추세는 죽었습니다)과 "풀백"(추세가 쉬고 있음)을 구별합니다.
사용자 이점: AI가 기본 추세 구조가 여전히 손상되지 않았음을 확인하므로 승자를 더 오래 보유합니다("이익 실행 허용").
4. 거래 제어 화면: 직접 관리하고 유연하게 조정
결정적으로 이것은 돈을 입금하고 최선을 다하는 "블랙 박스"가 아닙니다. 플랫폼은 다음과 같이 설계되었습니다. 힘 승수 . 귀하는 귀하의 포트폴리오 관리자입니다. AlphaNet가 구축한 강력한 파이프라인은 실행 팀입니다.
즉각적인 "킬 스위치" 및 유동성:
- 사용자는 양육권을 유지합니다. 모든 전략을 중단하고, 포지션을 청산하고, 자금을 즉시 인출할 수 있습니다. 일반적으로 헤지펀드와 관련된 락업 기간은 없습니다.
"슬라이스 앤 다이스" 사용자 정의:
사용자는 특정 시장 관점에 맞게 전략을 혼합할 수 있습니다.
예: 사용자는 낙관적이지만 변동성을 예상합니다. 그들은 할당할 수 있다 AI 마이크로트렌드에 70% (움직임을 잡기 위해) 및 AI 스캘핑 30% (단기 가격 변동에서 수익 기회를 찾습니다).
유연한 거래 모드:
수동 모드: 사용자는 거래 비용과 미끄러짐을 최소화하기 위한 상황별 우위 및 알고리즘 실행을 위한 AI Insight 모델의 지원을 받아 자신의 스타일을 사용하여 거래합니다.
자동조종장치: 사용자는 다양한 AI 전략에 자본을 유연하게 할당하고 Autopilot 모드에서 실행하여 전략 간을 최적화할 수 있습니다.
AI 스캘핑: 사용자는 짧은 시간 내에 반자동 거래에 사용할 수 있는 AI 스캘핑 전략(레버리지 지원)을 사용합니다. 이 모드는 스캘핑 트레이더에게 최적화된 엣지, PnL 및 승률을 제공합니다.
5. AI 알고리즘 실행
그만큼 AI 알고리즘 실행 기능은 서투른 시장 주문을 기관 수준의 알고리즘 로직으로 대체하여 소매와 도매 유동성 간의 격차를 해소함으로써 소매 거래를 변화시킵니다. 시장에 영향을 미치고 미끄러짐을 초래하는 즉시 거래를 실행하는 대신 사용자는 TWAP (시간 가중 평균 가격), VWAP (거래량 가중 평균 가격) 또는 하이브리드 AI 알고리즘. 이러한 에이전트는 주문을 지능적으로 조각화하여 특정 기간 또는 대량 창에 걸쳐 주문을 실행하여 거래자의 발자국을 가립니다. 이러한 정밀도는 독성 슬리피지를 제거할 뿐만 아니라 "네거티브 슬리피지"(가격 개선)를 적극적으로 목표로 삼고 AI를 사용하여 실행 중 마이크로 딥을 포착하여 거래 시작 시 시장 평균보다 더 나은 진입 가격을 확보합니다.
결정적으로, 이 실행 레이어는 전체 플랫폼에서 범용 유틸리티 역할을 하며 "보이지 않는 손" 역할을 합니다. 표준(수동) 거래, 자동조종장치 볼트 및 AI 스캘핑 전략. 수동 트레이더가 가격 변동 없이 천천히 스윙 포지션을 축적하기를 원하든, 스캘핑 봇이 수천 개의 마이크로 포지션을 효율적으로 청산해야 하든, 알고 엔진은 전체 프로세스를 자동화합니다. 이 "설정 후 잊어버리기" 기능은 사용자의 화면 시간을 절약하는 동시에 모드에 관계없이 모든 거래가 최고 수준의 퀀트 펀드의 비용 효율성으로 결제되도록 보장합니다.
핵심 가치 포인트:
영향이 없는 항목: "Iceberg" 논리를 사용하여 대규모 주문 규모를 숨기고 약탈적인 선점 및 MEV 봇을 방지합니다.
가격 개선: 동적 라우팅은 스프레드를 포착하여 실행 비용을 잠재적 이익(음의 슬리피지)으로 전환합니다.
범용 통합: 수동 거래, 패시브 투자 및 액티브 AI 스캘핑을 모두 지원하는 단일 실행 레이어입니다.
6. 알파의 집단적 자기 보존
"게이트키핑" 메커니즘은 플랫폼의 핵심 임무인 알파 생성을 위한 디지털 면역 시스템의 역할을 합니다. 퀀트 트레이딩에서는 알파는 유한 자원입니다; 모든 전략에는 더 많은 자본을 추가하면 하락과 시장 영향으로 인해 모든 사람의 수익이 희석되는 "포화점"(용량)이 있습니다. 따라서 플랫폼은 엄격한 "알파-자본 균형": 사용자 온보딩은 알고리즘에 따라 조절됩니다. 총 배포 가치(TVD) 는 탁월한 수익을 창출하는 플랫폼의 직접적인 능력을 결코 초과하지 않습니다. 전통적인 "어떤 대가를 치르더라도 성장" 모델 대신 이 DEX는 기존 사용자의 엣지 보존을 우선시하여 멤버십이 플랫폼의 성능 지표에 의해 유지되는 특권인 "자체 보존 집단"을 만들어 "공유지의 비극"이 결코 커뮤니티의 이익을 침식하지 않도록 보장합니다.
사용자 계층화 및 "가치 창출" 능력주의
가장 희소한 하이 알파 전략에 접근할 수 있는 사람을 결정하기 위해 플랫폼은 단순한 "볼륨 계층"을 포괄적인 계층으로 대체합니다. "가치 창출" 점수. 이 점수는 생태계에서 단순히 이익을 얻는 것이 아니라 생태계 건강에 기여하는 사용자를 식별하고 보상합니다.
요소:
순 알파 생성(PnL): 지속적으로 수익성 있게 거래하는 사용자(도구를 잘 사용하고 있음을 증명)는 무모한 거래자보다 우선시됩니다.
총 배포 가치(TVD): "Autopilot" 또는 "AI 스캘핑" 금고에서 활성화된 자본의 기간 및 규모(간단한 TVL과 구별되며 이는 적극적인 참여를 측정합니다).
실행 효율성: 사용자가 "낮은 영향" 실행 도구(TWAP/VWAP)를 사용하는 빈도와 DEX의 유동성을 손상시키는 독성 시장 주문을 기준으로 한 점수입니다.
생태계 수명: 인출 없이 자본이 배치된 기간을 기준으로 가중 연공 서열(충성도 승수).
마케팅 및 추천 가치: 플랫폼에 가져온 새로운 품질의 사용자에 대한 정량적 속성입니다.
거버넌스 참여: 전략 매개변수 업데이트 또는 새 모델 배포에 대한 투표 활동 비율입니다.
7. 요약: 새로운 소매 패러다임
| 기능 | 기존 소매 봇 | 딥 러닝 AI Perp DEX |
|---|---|---|
| 데이터 입력 | 가격 및 거래량 기반 지표 | 수천 가지 요소 (시장, 파생상품, 주문장) |
| 논리 | 하드 코딩된 "If/Then" 규칙 | 심층 신경망 (비선형 확률) |
| 사용자 역할 | 패시브 / 무기력 / 제한적 | 액티브 커맨더 (슬라이스 앤 다이스 전략) |
| 유연성 | 켜짐 또는 꺼짐 | 하이브리드 모드 (수동 거래, Autopilot 자동 거래 및 AI 스캘핑) |
| 결과 | 동전 뒤집기 확률 | 제도적 확률 거래 우위 |
8. 기관 파트너십 – AlphaNet의 기술 백본
AlphaNet는 AlphaNet의 노하우, 인프라 및 컴퓨팅 백본 역할을 수행하기 위해 아시아 전역의 소수의 퀀트 투자 회사 및 소품 거래 회사와 파트너십을 맺었습니다.
즉, Tensor Investment 는 AlphaNet의 AI DEX를 뒷받침하는 전략, 알고리즘 실행 및 컴퓨팅 인프라를 지원하는 주요 기술 파트너입니다. Tensor는 추세 추종, 평균 회귀 또는 차익거래의 일반적인 범주에 맞지 않는 다양한 SOTA(최첨단) 딥 러닝 기반 전략에 걸쳐 암호화폐, 채권, 주가 지수 및 상품 선물을 포함하되 이에 국한되지 않는 다양한 상품을 거래하는 다중 전략 자기자본 운용사입니다.
Tensor의 컴퓨팅 무기고에는 1000개가 넘는 고성능 GPU 노드(A100/H100)와 경량의 특수 엣지 노드가 포함되어 있으며 컴퓨터 과학, 물리학, 컴퓨터 생물학 및 수학 배경의 노련한 연구원으로 구성된 고도로 전문화된 팀이 있습니다.
자세한 내용은 다음을 방문하세요. https://www.tensorcorp.com/
C. 자동 거래 시스템 아키텍처
I. "AI"의 정의
체계적이고 퀀트 트레이딩에서는 생성 AI(LLM) 및 딥 러닝(DL)/심층 강화 학습(DRL) 는 뚜렷한 구조적 목표를 가진 근본적으로 다른 도구입니다.
LLM은 임의 연구 및 정서 분석을 변화시키고 있지만 체계적이고 지연 시간이 짧은 거래 시스템의 핵심 엔진에는 대체로 적합하지 않습니다.
1. 근본적인 목표 불일치
주된 이유는 손실 함수 (모델이 최적화하려고 하는 것).
생성 AI(LLM): 목표는 다음 토큰 예측 (교차 엔트로피 손실 최소화). 이 모델은 확률론적이며 그럴듯한 텍스트를 생성하도록 설계되었습니다. 본질적으로 묻습니다. "가장 가능성이 높은 다음 단어는 무엇입니까?"
딥 러닝(DL): 목표는 일반적으로 차별적 (평균 제곱 오류 또는 분류 오류 최소화). 그것은 묻는다, "다음 100ms 동안 가격이 상승할 정확한 확률은 얼마입니까? 아니면 다음 2시간 동안 가격 변화가 어떻게 예측됩니까?". 딥러닝은 본질적으로 시계열적이고 순차적인 거래 전략을 구축하는 데 사용되며 일관된 결과로 백테스트될 수 있습니다.
심층 강화 학습(DRL): 목표는 보상 극대화 (예: 샤프 비율, PnL 최대화 또는 구현 부족 최소화) 모델이 묻는다. "어떤 조치(매수/매도/보류)가 장기 누적 보상을 극대화합니까?" 강화 학습 모델은 사용자 정의 목표에 대한 결과를 최대화하는 작업에 중점을 둡니다.
이것이 중요한 이유: LLM은 주식이 상승해야 하는 이유에 대해 설득력 있는 설명을 작성할 수 있지만 위험 조정 수익률을 최적화하거나 시장 미시 구조의 확률론적 특성을 처리하기 위한 수학적 프레임워크가 부족합니다.
2. 대기 시간: LLM 병목 현상
대기 시간이 짧고 빈도가 높은 거래(HFT)에서는 속도가 알파입니다.3
LLM: 추론은 방대합니다. 일반적인 프론티어 LLM에서는 단일 토큰을 생성하기 위해 의미 있는 GPU 메모리와 계산 시간이 필요합니다. 지연 시간은 다음으로 측정됩니다. 수백 밀리초 초까지.
기존 DL/DRL: 알파 신호 생성에 사용되는 소형 LSTM, MLP(Multi-Layer Perceptron) 또는 CNN은 에지 장치 및 FPGA 또는 특수 ASIC에서도 실행되도록 고도로 최적화(프루닝, 양자화)될 수 있습니다. 추론 대기 시간은 다음과 같이 최적화될 수 있습니다. 밀리초 또는 한 자리 숫자 밀리초.
병목 현상: 더 높은 빈도의 스캘핑 전략이 구매 결정을 내리는 데 몇 초가 걸린다면 우위의 상당 부분이 이미 사라졌을 가능성이 높습니다.
3. 데이터 표현: 수치적 정밀도와 의미론적 토큰
시장 시계열 데이터는 자연어와 근본적으로 다릅니다.
토큰화 문제: LLM은 텍스트 토큰을 처리합니다. LLM에 가격 데이터를 제공하려면 숫자(예: "100.50")를 토큰화해야 합니다. 이는 값 간의 연속적인 수치 관계를 파괴합니다. LLM은 "100"과 "50"을 연속 미분 가능 수량으로 보지 않고 토큰으로 간주합니다.
딥 러닝: 신경망은 원시 부동 소수점 텐서를 입력으로 사용합니다. 가격, 거래량, 주문장 깊이의 미세 상관관계를 탐지하는 데 필요한 수치적 정밀도를 유지합니다.
4. 견고성과 환각
기관 시스템이 우선순위를 정합니다. 신뢰성 및 안전 .
비결정론: LLM은 설계상 확률론적입니다(온도 > 0). 동일한 시장 데이터를 LLM에 두 번 공급하면 두 가지 다른 거래 권장 사항을 얻을 수 있습니다. 체계적인 거래에는 결정론적이고 재현 가능한 논리가 필요합니다.
환각: LLM은 사실을 "환각"하거나 근거를 만들어낼 수 있습니다. 거래에서 "환각"은 펀드를 파산시킬 수 있는 실수입니다.
딥 러닝: DL 모델은 "블랙박스"일 수 있지만 추론 중에는 결정적입니다(드롭아웃 비활성화). 출력을 수학적으로 바인딩하고 효과적으로 스트레스 테스트를 수행할 수 있습니다.
5. 요약 - 비교
| 기능 | 생성 AI(LLM) | 딥 러닝/DRL |
|---|---|---|
| 핵심 작업 | 텍스트/컨텐츠 생성 | 패턴 인식/제어 |
| 입력 데이터 | 구조화되지 않은 텍스트/이미지 | 구조화된 시계열(틱, OHLCV) |
| 추론 속도 | 느림(ms~초) | 빠름(마이크로초) |
| 출력 특성 | 확률적, 창의적 | 결정성, 정확성 |
| 위험 | 환각, 불일치 | 과적합(그러나 관리 가능) |
| 최고의 사용 사례 | 감정 분석, 뉴스 파싱 | 실행, 알파 신호, 위험 관리 |
Quant의 생성 AI를 위한 "스위트 스팟"
LLM은 거래하지 않지만 점점 더 퀀트 2.0 워크플로우 지원 역할:
감정 신호 생성: 연준 의사록, 실적 보고서 또는 Reddit 감정을 읽고 이를 숫자 점수(0~1)로 변환한 다음 전통적인 딥 러닝 모델에 입력합니다.
코딩 보조: 퀀트가 엔진 백테스팅을 위한 Python/C++ 코드를 작성하는 데 도움을 줍니다.
데이터 정리: 구조화되지 않은 대체 데이터(예: 배송 목록, 신용 카드 거래 설명)를 구문 분석합니다.
요인/특징 발견: 전략 파이프라인에 테스트할 요인에 대한 아이디어가 부족한 경우 LLM을 사용하여 원시 데이터 포인트(가격, 거래량, LOB, OI, 매크로 등)에서 요인 생성 아이디어를 제공할 수 있습니다.
II. 미지의 영역 확장 – 딥러닝 기반 퀀트 트레이딩
딥 러닝(DL)이 컴퓨터 비전 및 NLP와 같은 분야를 정복했지만 정량적 거래에서는 직관적으로 언급했듯이 업계 설계에 따라 대부분 "부분적으로 차트화된 영역 또는 "미지의 영역"으로 남아 있습니다. 이는 기술이 미성숙하기 때문이 아니라 금융 데이터는 적대적이며 오탐으로 인한 비용은 파산입니다., 이상하게 생성된 이미지가 아닙니다.
AI 거래에서 "강력한 시스템 설계"가 왜 그렇게 어려운지, 표준 "플레이북"이 없는 이유, 그리고 이를 해결한 소수의 기관 플레이어가 어떻게 자신의 방법을 잠그는지에 대해 알아보겠습니다.
1. "영업 비밀" 해자(금융 분야에는 "ImageNet"이 없는 이유)
Tech(Google, Meta)에서는 출판 연구에 인재가 모입니다. 금융 부문, 연구 출판 가 알파를 파괴합니다.. 펀드가 변동성을 성공적으로 예측하는 특정 DL 아키텍처를 발견하면 이를 게시하면 경쟁업체가 몇 주 내에 신호를 차익거래할 수 있습니다.
결과: 공유된 커뮤니티 지식 기반이 없습니다. Renaissance Technologies의 "모범 사례"는 Two Sigma에서는 "초보 실수"로 간주될 수 있으며 둘 다 알 수 없습니다.
대비: 컴퓨터 비전에서는 ResNet 또는 Transformer가 표준 백본이라는 데 모두가 동의합니다. Quant에서는 LSTM, Transformer 또는 단순 MLP를 사용할지 여부에 대한 합의가 없습니다.
2. '블랙박스' 신뢰 장벽(채택 지연)
많은 성공적인 전통적 퀀트 펀드는 신뢰하는 물리학자와 통계학자에 의해 운영됩니다. 선형 설명.
Quant 2.0(전통): 연구원은 요인(예: "모멘텀")을 발견하고 수학적으로 연결한 다음 선형 회귀 모델을 작성하여 이를 거래합니다. 깨지면 그 이유를 알고 있습니다.
Quant 3.0(딥 러닝): 모델은 가격, 거래량, 시간대와 관련된 비선형 패턴을 발견합니다. 폭락 중에 갑자기 많이 팔리기 시작하면 연구자는 위험 관리자에게 그 이유를 설명할 수 없는 경우가 많습니다.
미지의 문제: 모범 사례와 강력하고 표준화된 도구가 부족합니다. 설명 가능 AI(XAI) . 위험 관리자나 CIO가 신경망의 결정을 체계적으로 "감사"할 수 있을 때까지 대부분의 자금은 실행 엔진의 열쇠를 제공하지 않습니다.
3. 복잡성과 대규모 검색 공간
양적 금융에서 AI의 "미지의" 성격에 기여하는 핵심 요소는 바로 복잡성 및 검색 공간 . 고정된 규칙(예: 체스)이나 정적 대상(예: 이미지 인식)의 문제와 달리 시장은 광대하고 지속적으로 변화하는 가능성의 환경입니다. 거래 시스템은 단순한 단일 모델이 아닙니다. 그것은 수십 개의 서로 맞물린 결정으로 이루어진 복잡한 사슬입니다.수천 가지 기능 중에서 선택할 수 있는 100가지 기능, 신경 아키텍처(LSTM, Transformer, N-BEATS) 를 사용합니다. 완전한 엔드투엔드 시스템의 가능한 순열 수는 사실상 무한합니다.
이로 인해 엄청난 계산 병목 현상이 발생합니다. 이 검색 공간의 작은 부분이라도 탐색하려면 각기 다른 구성으로 수천 개의 백테스트를 동시에 실행할 수 있는 엄청난 HPC(고성능 컴퓨팅) 리소스가 필요합니다. 더욱이, 처리할 핵심 모델 주위에 강력한 주변 시스템을 구축해야 하므로 검색이 복잡해집니다. 설명 가능성 (특정 시장 국면에서 "블랙박스"가 결정을 내린 이유를 해석) 및 과적합 완화 (과거 데이터만으로 전략이 성공하지 않도록 보장)
이러한 복잡성의 주요 측면은 다음과 같습니다.
조합 폭발: 전체 검색 공간은 모든 단계에서 가능한 모든 선택의 산물입니다(기능 세트 x 모델 아키텍처 x 하이퍼파라미터 x 시장 국면 정의 x 실행 규칙).
비정상성 세금: 시장 규칙이 바뀌기 때문에 2020년에 최적이었던 구성이 2025년에는 재앙이 될 수 있으며 지속적이고 비용이 많이 드는 재검색과 재교육이 필요할 수 있습니다.
"주변 장치" 부담: 핵심 딥 러닝 모델을 구축하는 것은 작업의 20% 미만인 경우가 많습니다. 엔지니어링 노력의 대부분은 모델을 실제 자본으로 배포할 수 있을 만큼 안전하고 설명 가능하게 만드는 "비계"를 구축하는 데 사용됩니다.
III. AI 정량거래 시스템 설계
[걱정하지 마세요. 이것은 AlphaNet의 시스템 설계에 대한 아이디어를 제공하는 매우 손쉬운 개요이며 수백 가지의 고유한 세부 정보나 핵심 IP를 공개하지 않습니다. 이 개요로 인해 해자나 거래 우위가 손실되지 않습니다.]
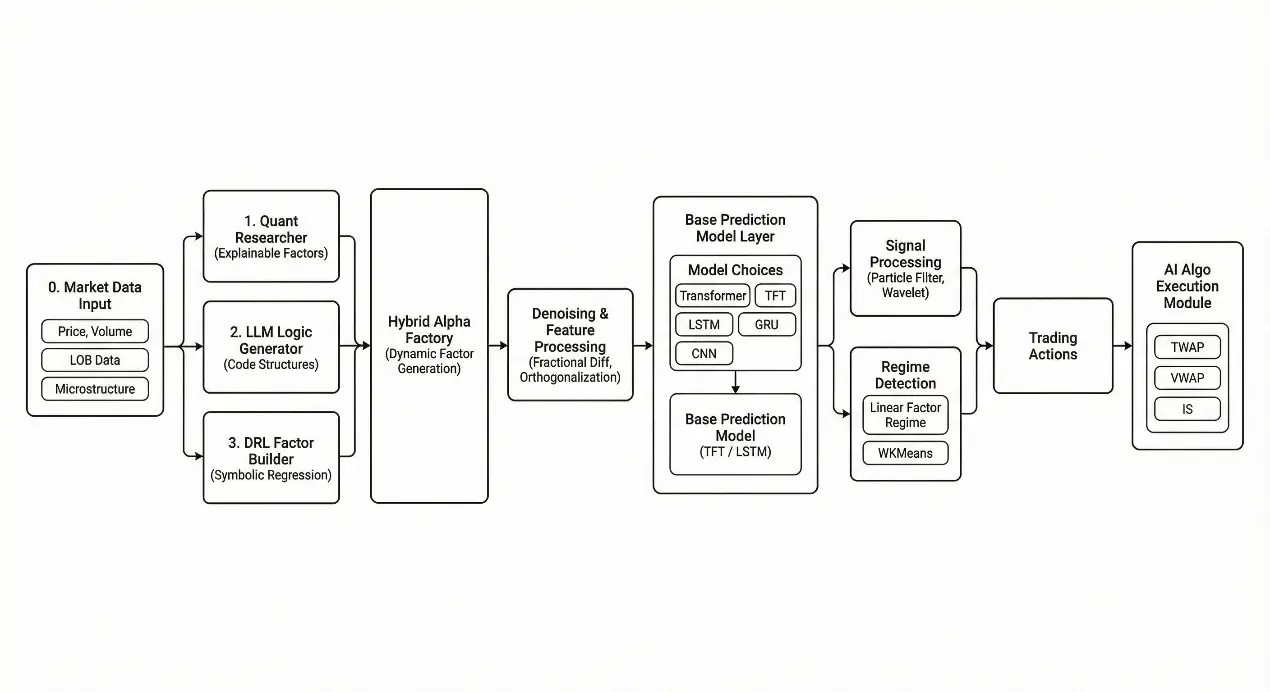
AlphaNet 파이프라인의 전체 구조는 데이터 처리, 요인/특성 발견 + 평가, 모델 선택, 교육 반복, 알파 붕괴 완화(나중에 자세히 설명됨) 및 거래의 역동성과 최적 제어의 끝없는 주기를 생성하는 데 중점을 둡니다.
대략적인 흐름은 다음 다이어그램으로 설명할 수 있습니다.
1. 1단계: 하이브리드 알파 팩토리(동적 요소 생성)
자동화된 기능 구성의 방법론은 다음을 참조하세요. 시장 미세구조에 대한 체계적인 특징 및 인자 마이닝.
이 모듈은 다음과 같이 작동합니다. 상징적 경쟁. 이 단계의 출력은 예측이 아니라 다음 라이브러리입니다. 실행 가능 요소 (수학 공식).
1. Quant Researcher("화이트 박스" 앵커)
역할: 경제 이론 및 시장 미시 구조를 기반으로 한 "사전"을 제공합니다.
입력: 원시 LOB(한도 주문장) 데이터, 트레이드 테이프.
출력: 설명 가능한 기능.
예: 주문 흐름 독성(VPIN). 연구원은 정보가 있는 거래자와 잡음 거래자가 실행하는 거래량의 비율을 측정하기 위해 논리를 수동으로 코딩합니다.
유지 이유: 이러한 요인은 안정적인 기준선을 제공하고 모델이 경제 논리를 무시하는 허위 상관관계를 학습하는 것을 방지합니다.
2. "논리 생성기"로서의 LLM(심볼릭 아키텍트)
메커니즘: 우리는 수학 연산 및/또는 금융 라이브러리(Pandas, Polars)에 대해 미세 조정된 LLM(예: Kimi K2 또는 특수 Deepseek Math V2)을 사용합니다.
프롬프트 엔지니어링: "50ms 창에 걸쳐 최고 입찰에서 지정가 주문 추가 비율과 취소 비율을 비교하여 '유동성 보충 비율'을 캡처하는 Polars를 사용하여 Python 함수를 생성합니다."
출력: 새로운 요소를 나타내는 Python/C++ 코드 조각을 구문적으로 수정합니다.
값: LLM은 추상적인 시장 개념("유동성이 마르면 일반적으로 가격 모멘텀이 반전됩니다")을 실행 가능한 코드((ask_vol - bid_vol) / Rolling_std)로 변환하는 고속 주니어 연구원 역할을 합니다.
3. DRL 기반 요소 구성("빌더")
상태공간: 현재 유효한 요인 세트와 해당 상관 행렬입니다.
동작 공간(이산): 연산 및 피연산자 라이브러리입니다.
피연산자: 시가, 청산, 거래량, Bid_Size_L1, Ask_Size_L1.
운영자: +, -, /, Delta(), Ts_Rank(), Log(), Decay().
프로세스: DRL 에이전트는 계산 그래프 (구문 트리) 단계별. 간단한 예:
1단계: 닫기를 선택합니다.
2단계: 선택 - (마이너스).
3단계: 열기를 선택합니다.
4단계: / (나누기)를 선택합니다.
5단계: VWAP를 선택합니다.
보상 기능: 결과 요소의 정보 계수(IC)는 수식의 복잡성으로 인해 불이익을 받습니다(절약 원칙). 이는 단지 과적합된 노이즈인 "부풀어오른" 요인을 방지합니다.
2. 2단계: 잡음 제거 및 특징 처리
분수 미분: 정상성을 보장하면서 메모리를 보존합니다.
직교화: PCA 또는 QR 분해를 사용하여 새로운 DRL 생성 요소 추가를 보장합니다. 고유 정보는 Quant Researcher의 기존 요소의 단순한 선형 조합이 아닙니다.
3. 3단계: 모델 선택(기본 예측)
선호도 중심 전략 평가 및 포트폴리오 구성을 보려면 다음을 읽어보세요. 에이전트.
핵심 아키텍처: TFT(Temporal Fusion Transformer), LSTM, GRU 또는 Transformer.
역할: 1단계(Quant + LLM + DRL 요인)에서 100개 이상의 입력을 가져와 다음 기간(예: 5m, 1H, 2H, 4H 등)에 대한 수익 확률 분포를 출력합니다.
4. 4단계: 신호 생성 및 제어 메커니즘
이 모듈은 3단계의 시끄러운 확률을 정확하고 강력한 거래 활동으로 변환합니다.
하위 모듈 A: 신호 처리(필터 계층)
우리는 고급 필터링을 적용하여 시장 잡음에서 신호의 "진정한 상태"를 분리합니다.
웨이블릿 변환: 신호를 다양한 주파수 구성 요소로 분해합니다(추세를 유지하면서 고주파수 지터 제거).
지수평활: 기준선 추세 추적을 위한 표준 EWMA.
입자 필터링(순차 몬테카를로): [신규 추가]
개념: 칼만 필터(가우시안 노이즈를 가정)와 달리 입자 필터는 시장이 비선형 및 비가우시안이라고 가정합니다.
메커니즘: 시스템은 X개의 "입자"(실제 신호의 가상 상태)를 생성합니다. 새로운 가격 데이터가 도착하면 데이터와 일치하는 입자가 다시 샘플링(생존)되고 표류하는 입자는 삭제됩니다.
결과: 실제 신호 값의 확률 밀도 함수입니다. 이를 통해 시스템은 다음과 같이 말할 수 있습니다. "모델은 Up을 예측하지만 입자 분산이 커서 신호 품질이 낮습니다. 거래하지 마십시오."
하위 모듈 B: 동적 거래 규칙(결정 계층)
현재 환경에서 거래를 어떻게 구현합니까?
1. WKMeans(Wasserstein K-Means), HMM 및 선형 시장 국면을 통한 시장 국면 감지
구현: 우리는 다양한 유형의 시장 국면 모델(변동성, 거래량, 스프레드, 엔트로피, 추세 등)을 기준으로 시장 상태를 클러스터링합니다. 우리는 시간 감쇠 가중치 함수를 추가합니다. 최근 관찰 결과는 군집 중심을 결정할 때 더 높은 가중치를 갖습니다.
시장 국면 A: 높은 유동성/낮은 거래량(평균 회귀 논리 활성화).
시장 국면 B: 유동성 충격/높은 거래량(돌파 로직 활성화).
시장 국면 C: 독성 흐름(거래 중단).
이를 통해 시장 구조가 변화함에 따라 시장 국면 정의가 시간이 지남에 따라 천천히 표류할 수 있습니다.
2. 구현 로직(하이브리드 제어)
The final output is derived from a mapping of (Signal Strength $\times$ Regime):
시나리오: 입자 필터는 높은 신뢰도를 보여주며 WKMeans는 "시장 국면 A"를 감지합니다.
- 동작: 선형 제어 시스템. 스프레드를 포착하기 위해 터치 시 패시브 지정가 주문을 사용하여 실행합니다.
시나리오: 입자 필터는 높은 신뢰도를 보여주며 WKMeans는 "Regime B"(빠른 이동)를 감지합니다.
- 동작: 공격적인 저격수. 알파 붕괴 직전에 스프레드(시장 주문)를 교차하여 진입합니다.
데이터 흐름 요약(예 – 무작위 특정 모델/전략)
수량: 는 "확산 불균형"을 정의합니다.
LLM: "변동성에 따른 거래량 감소율"에 대한 코드를 작성합니다.
DRL 에이전트: 공식 순위(닫기) - 순위(볼륨)를 구축합니다.
하이브리드 요소 처리: 전체적인 시스템에 따라 기능 순위를 지정합니다.
예측: LSTM/Transformer는 "매수 확률: 60%"를 출력합니다.
신호 처리: 입자 필터는 60%를 분석하고 실제 신호가 실제로 모호한지(넓은 변동) 판단합니다.
컨텍스트: WKMeans는 우리가 "낮은 변동성" 시장 국면에 있다고 말합니다.
결정: 시스템이 유지됩니다(원시 예측에도 불구하고 필터가 신호를 거부함).
IV. 알파 붕괴 완화 – 번영의 샘
이는 AI 거래 파이프라인의 "수명 주기 관리" 계층입니다. 수량적이고 체계적인 거래에서는 알파 붕괴가 불가능합니다. 그것은 확실하다. 시장은 귀하의 신호에 적응하거나 구조적 관계(시장 국면)가 변경됩니다.
수동 개입 없이 이를 완화하려면 시스템은 전략을 다음과 같이 처리해야 합니다. 일회용 탄약. 파이프라인은 "사용된" 총알을 대체하기 위해 지속적으로 새로운 "총알"(전략)을 생산해야 합니다.
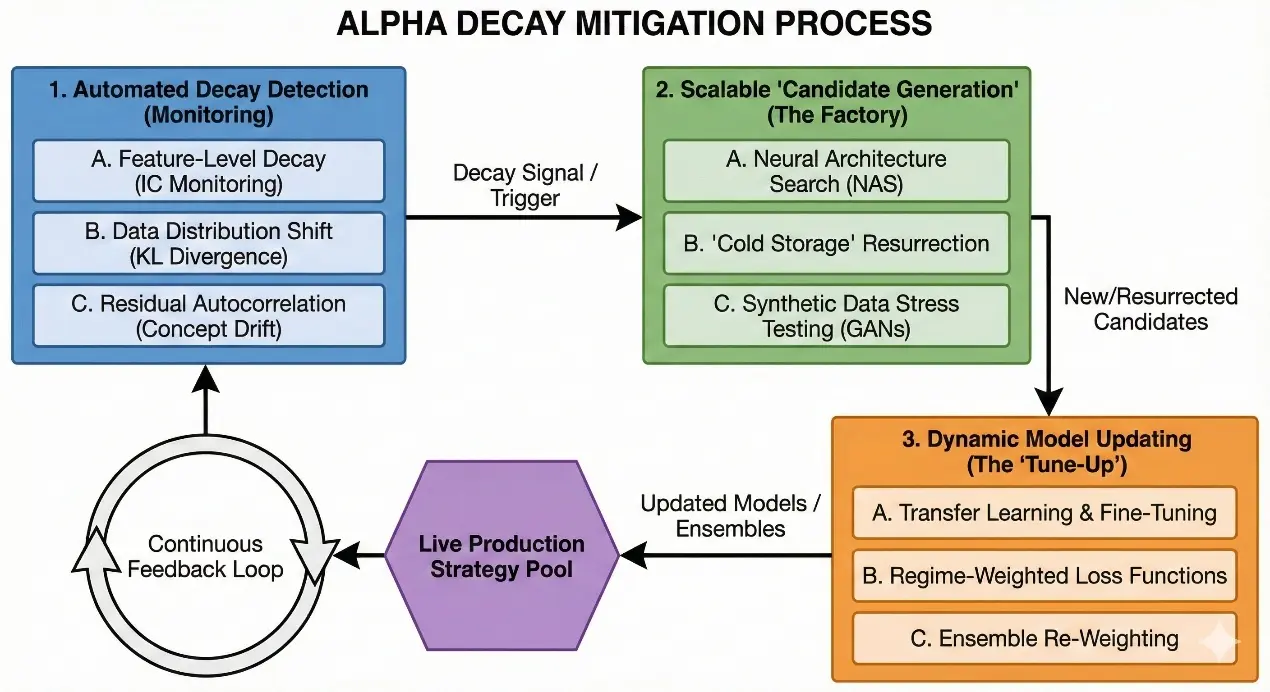
다음은 AlphaNet의 Alpha Decay Mitigation에 대한 기술 개요입니다. 이를 자체 품질 강화 공장 파이프라인으로 생각할 수 있습니다.
1. 자동 부패 감지("체크 엔진" 진단)
우리는 부패를 감지하기 위해 손익이 하락할 때까지 기다리지 않습니다. PnL은 후행지표입니다. 우리는 모니터링한다 주요 전신 지표 .
A. 기능 수준 붕괴(정보 계수 모니터링)
모델이 실패하기 전에 일반적으로 입력이 실패합니다. 우리는 정보 계수(IC) 핵심 요소의.
- 미터법: t의 팩터 값과 t+k의 수익률 사이의 롤링 순위 정보 계수(RankIC)입니다.
- 감쇠 트리거: If the 14-day moving average of the IC drops below a statistical threshold (e.g., $IC < 0.02$) or the IC 변동성 스파이크가 발생하면 해당 요소는 "깨짐"으로 표시됩니다.
B. 데이터 분포 이동(공변량 이동)
모델은 특정 데이터 분포를 학습합니다. 시장 미세 구조가 변경되면(예: 변동성이 두 배로 증가하거나 유동성이 새로운 패턴을 생성하는 경우) 입력 데이터 분포가 이동하여 모델의 학습된 가중치가 유효하지 않게 됩니다.
- 테스트: Kullback-Leibler(KL) 발산 또는 인구 안정성 지수(PSI).
- 논리: 입력 특징의 히스토그램을 비교합니다. 트레이닝 세트 대 지난 24시간.
- 임계값: KL 발산 점수가 높으면 모델이 연구한 적이 없는 데이터를 보기 때문에 본질적으로 "맹인" 상태임을 나타냅니다.
C. 잔차 자기상관(개념 드리프트)
- 논리: 정상적인 모델에서 오류(잔차)는 무작위 백색 잡음이어야 합니다.
- 감쇠 신호: 모델의 오류가 표시되기 시작하면 직렬 자기상관 (예: 모델이 연속 5회 지속적으로 과소 예측함)는 모델이 누락된 새로운 구조화된 신호가 시장에 있음을 의미합니다. "알파"가 "잔차"로 이동했습니다.
2. 확장 가능한 "후보 생성"(The Factory)
이 모듈은 HPC 클러스터의 백그라운드에서 지속적으로 실행됩니다. 거래되지 않습니다. 이는 포함될 준비가 된 교체 전략의 "벤치"를 만들기 위해서만 존재합니다.
A. 신경 아키텍처 검색(NAS)
연구원이 수동으로 모델을 선택하는 대신 컴퓨팅을 사용하여 최상의 토폴로지를 검색합니다.
검색 공간: 시스템은 다음의 조합을 통해 반복됩니다.
- 기본 모델: LSTM 대 GRU 대 Transformer(TFT) 대 TCN(Temporal Convolutional Network).
- 하이퍼파라미터: 숨겨진 차원 크기, 관심 헤드, 탈락률.
최적화: 우리는 사용합니다 베이지안 최적화(TPE) . 시스템은 특정 자산에 가장 적합한 아키텍처가 무엇인지 "학습"합니다(예: "ETH 쌍은 Transformers를 선호하지만 Alt 코인은 GRU를 선호합니다").
B. "냉장고"의 부활
Alpha는 자주 순환합니다. 2022년에 쇠퇴한 전략이 2025년에는 수익을 낼 수도 있습니다.
프로세스: 부패한 모델은 삭제되지 않습니다. "최대 절전 모드" 풀로 이동됩니다.
지속적인 재평가: 시스템은 매주 최신 데이터를 사용하여 최대 절전 모드 모델에 대해 간단한 백테스트를 실행합니다. "죽은" 전략이 갑자기 최근 데이터에서 Sharpe > 2.0을 표시하면 "활성 후보" 목록으로 다시 승격됩니다.
C. 합성 데이터 스트레스 테스트
새로운 후보자가 지난 달의 데이터에 과적합되지 않도록 하기 위해 다음과 같이 교육합니다. GAN이 생성한 시장 데이터.
방법: 생성적 적대 네트워크(GAN)는 자산의 통계적 속성을 모방하지만 "극단적인 시나리오"(폭락, 유동성 공백)를 포함하는 합성 가격 경로를 생성합니다.
선택: 합성 스트레스 테스트를 통과한 후보자만이 배포 자격을 갖습니다.
3. 동적 모델 업데이트("조정")
때때로 모델을 완전히 교체하는 데 비용이 많이 듭니다. 종종 우리는 그것을 현재 시장 국면에 맞게 조정하면 됩니다.
A. 전이 학습 및 미세 조정
베이스: 우리는 모든 자산에 걸쳐 5년간의 데이터를 학습한 대규모 "기초 모델"을 유지 관리합니다. 이는 보편적인 진실을 학습합니다(예: "볼륨 급증이 종종 변동성에 앞서는 경우가 있습니다").
머리: 특정 자산의 알파가 붕괴되면 기초 모델 레이어를 동결하고 가장 최근 3개월의 데이터에 대해서만 최종 출력 레이어(헤드)를 재교육합니다.
혜택: 여기에는 전체 교육 계산의 1%가 필요하지만 모델을 최근 시장 행동에 거의 즉각적으로 적용합니다.
B. 시장 국면 가중 손실 함수
재훈련 전략 시 모든 데이터가 동일하지는 않습니다. 우리는 모델이 오늘과 같은 데이터의 우선순위를 지정하기를 원합니다.
메커니즘: 시장 국면 탐지 모듈(WKMeans/HMM)을 사용하여 과거 데이터를 분류합니다.
훈련 중에 시장 국면에 따라 손실 모델에 가중치를 부여합니다.
결과: 오늘이 "고변동성 약세장"인 경우 모델은 업데이트 중에 "저변동성 강세장"의 데이터를 효과적으로 무시하고 현재 환경에 맞게 엄격하게 최적화합니다.
C. 앙상블 재가중화(위원회 투표)
특정 전략 구성에서는 하나의 모델에 의존하는 대신 앙상블 모델(예: 단기 추세 1개, 평균 회귀 1개, 변동성 급증 1개) 이는 일반적으로 앙상블 재가중화를 활성화하기 위한 구체적인 근거가 필요하며 일반적인 전략에는 사용되지 않습니다.
완화: 알파 붕괴는 일반적으로 하나의 특정 스타일에 영향을 미칩니다.
동작: 우리는 게이팅 메커니즘 (메타 모델)
결과: "추세" 모델이 실패하기 시작하면 해당 모델의 가중치가 자동으로 0으로 줄어들고 "평균 회귀" 모델의 가중치는 증가합니다. 개별 "구성 요소 알파"가 붕괴되더라도 "시스템 알파"는 견고하게 유지됩니다.
V. 정량적 거래 인프라 및 컴퓨팅 리소스
AlphaNet용 컴퓨팅 리소스는 Tensor 및 Phoenix SkyNet Node Network에서 제공됩니다. 아래는 사용된 하드웨어에 대한 개요입니다.
예를 들어, 60개 이상의 자산별 전략을 계산하려면 에는 계층형 고성능 컴퓨팅(HPC) 아키텍처. 모든 것을 GPU에 던질 수는 없습니다. "검색" 단계(훈련)와 "라이브" 단계(추론)의 요구 사항은 정반대입니다.
1. 컴퓨팅 아키텍처 분석
1. 하이브리드 알파 팩토리(로직 생성)
컴퓨팅 유형: GPU(추론 최적화)
워크로드: LLM은 코드 조각(공식)을 생성합니다. 이는 "과도한" 작업 부하입니다(아이디어를 대량으로 생성한 다음 테스트를 중단함).
하드웨어: NVIDIA A100(80GB) 또는 H100.
- 이유: 충분한 컨텍스트 창이 있는 고품질 코딩 LLM 모델을 실행하려면 대규모 VRAM이 필요합니다. 소비자 카드(RTX 4090)는 API 문서를 읽고 복잡한 Polars 코드를 작성하는 데 필요한 컨텍스트 길이로 인해 질식합니다.
2. DRL 팩터 빌더("검색" 엔진)
컴퓨팅 유형: 하이코어 CPU(기본) + 미드레인지 GPU(보조)
워크로드: DRL 에이전트(PPO)는 환경과 상호 작용합니다.
- 병목 현상: 환경 시뮬레이션. 60개 자산에 대한 5년간의 틱 데이터에 대한 공식의 손익을 계산하는 것은 CPU 바인딩된 연속 작업입니다.
하드웨어: 듀얼 AMD EPYC(96+ 코어) 또는 Threadripper.
이유: 60개 환경을 동시에 시뮬레이션하려면 대규모 병렬 처리가 필요합니다. GPU는 작은 신경망 정책(몇 밀리초)을 업데이트하는 데만 사용되는 반면, CPU는 거래를 시뮬레이션하는 데 몇 초를 소비합니다.
규칙: 1 GPU 비율: 64 CPU 코어.
3. 잡음 제거 및 특징 처리(FracDiff)
컴퓨팅 유형: GPU(CUDA 커널)
워크로드: 매트릭스 작업.
하드웨어: NVIDIA RTX 6000 Ada 또는 A6000.
- 이유: 분수 미분을 위한 표준 CPU 루프가 너무 느립니다. 맞춤형 CUDA 커널은 이 속도를 400배까지 높일 수 있습니다. 여기서는 AI에 필요한 Tensor 코어보다 FP32 처리량을 우선시합니다.
4. 기본 예측 모델(훈련)
컴퓨팅 유형: GPU(Tensor 코어 최적화)
워크로드: 교육용 Transformer/LSTM. 이것은 순수한 행렬 곱셈입니다.
하드웨어: NVIDIA H100s, A100s, Alibaba PPU 또는 Huawei 910C 클러스터
이유: Transformer 아키텍처를 사용하여 60개의 개별 자산 모델을 교육하는 것은 어렵습니다. "Walk-Forward Validation"(매주 확장 창에서 모델 재교육)을 수행하면 수천 개의 모델을 효과적으로 교육할 수 있습니다.
최적화: 사용 혼합 정밀도(FP16) .
5. 신호 처리 및 실행(추론)
컴퓨팅 유형: 고주파수 CPU
워크로드: 입자 필터링 및 실행 논리.
하드웨어: 오버클럭된 Intel Core i9(5.5GHz+) 또는 AMD Ryzen 9.
- 이유: 대기 시간. RAM에서 GPU 메모리로 데이터를 이동하고 다시 이동하는 데는 마이크로초가 걸립니다(PCIe 병목 현상). if/else 문 및 입자 필터(순차 몬테카를로 방법)와 관련된 실행 논리의 경우 빠른 CPU가 GPU를 능가합니다.
2. "조합 폭발": 이 기능이 필요한 이유
그러한 파이프라인이 이 컴퓨팅이 필요한 "수많은 버전"을 생성하는 이유를 물으셨습니다. 이는 다음과 같이 알려져 있습니다. 시스템 설계의 차원성의 저주.
전통적인 회귀 모델에서는 Y = mX + b를 적합합니다. 이 파이프라인에서 다이어그램의 모든 단일 화살표는 검색 공간.
1. 시간 범위 및 기능 세트 승수(20x – 30x 로드)
하나의 모델을 훈련할 수 없습니다. 특정 기간 및 기능 세트에 대해 특정 버전을 교육해야 합니다.
표준: 열차 모델 A.
견고함: 열차 모델 A1(1H 지평선, 기능 세트 A) 모델 A2(2H 지평선, 기능 세트 B)… A_N
결과: 귀하의 60개 자산이 방금 1200+ 모델 훈련하고 유지하는 것입니다.
2. 하이퍼파라미터 그리드("그리드 검색" 세금)
이론적으로 하이퍼파라미터 최적화는 세분화되지 않은 규모로만 수행됩니다(지나치게 최적화하면 문제가 발생함). 그러나 전반적인 딥 러닝 모델은 매우 민감합니다. 60개 자산 각각에 대해 시스템은 자동으로 테스트해야 합니다(예):
학습률: [1e-3, 1e-4, 5e-4]
조회 기간: [50, 100, 200]
탈락률: [0.1, 0.3, 0.5]
결과: 3 x 3 x 3 = 모델별 자산당 변형 27개.
3. 워크포워드 교차 검증("시간" 세금)
시장에서는 2022년에 훈련하고 2023년에 테스트를 한 번 할 수 없습니다. 당신은 수행해야합니다 롤링 윈도우 백테스팅.
열차 1월~3월, 테스트 4월
열차 2월~4월, 5월 테스트.
열차 3월~5월, 6월 테스트
결과: 이는 컴퓨팅 요구 사항에 "Folds" 수(예: 1년에 52주)를 곱합니다.
요약 테이블: 계산 청구서
| 모듈 | 기본 하드웨어 | 역할 | 왜요? |
|---|---|---|---|
| 로직 생성(LLM) | GPU(높은 VRAM) | 코드 생성 | 70B 매개변수 모델에는 80GB+ VRAM이 필요합니다. |
| 알파 검색(DRL) | CPU(하이코어) | 시뮬레이션 | 10년간의 틱 데이터 시뮬레이션은 CPU에 바인딩됩니다. |
| 노이즈 제거 | GPU(CUDA) | 매트릭스 작전 | CPU 대비 분수 차분의 속도가 400배 향상되었습니다. |
| 모델 교육 | GPU(Tensor 코어) | 딥 러닝 | Transformer를 위한 대규모 병렬 행렬 곱셈. |
| 신호/실행 | CPU(하이 클록) | 순차 논리 | PCIe 대기 시간을 방지합니다. 순차 수학은 CPU에서 더 빠릅니다. |
VI. 자동화된 거래 시스템에 대한 과적합 완화
딥러닝을 주로 사용하지 않는 많은 퀀트 트레이딩 회사의 주요 관심사 중 하나는 모델 과적합입니다. AlphaNet에는 과적합을 위한 특정 프로세스가 있으며 이를 다음과 같이 지칭합니다. 적대적 검증 게이트.
표준 딥 러닝에서는 훈련(드롭아웃, 정규화) 중에 과적합 완화가 발생합니다. 기관의 양적 거래에서는 금융 데이터가 고정적이지 않기 때문에 이는 충분하지 않습니다. 모델은 2018~2022년 데이터에서 완벽하게 정규화될 수 있으며, 2023년에는 과적합으로 인해 크게 실패할 수 있습니다. 시장 국면 구조 과거의.
제안된 메커니즘은 모델 훈련 이후와 서류 거래 이전에 위치합니다. 이는 매개변수 취약성 및 시장 국면 의존성과 관련된 특정 약점을 공격하여 모델을 깨뜨리도록 설계된 고문실입니다.
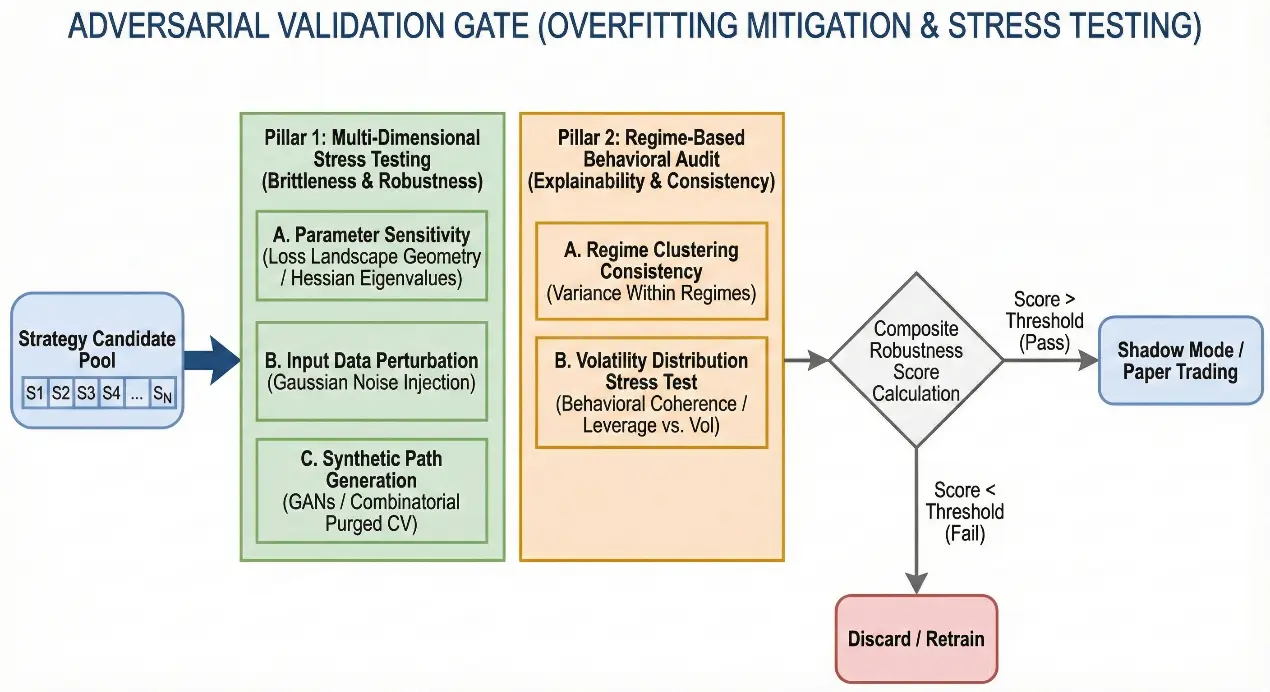
아키텍처: 적대적 검증 게이트
이 모듈은 훈련된 "후보 모델"(가중치 고정)을 가져와 이를 측정하는 일련의 검증 테스트에 적용합니다. 일반화 격차 는 시간뿐만 아니라 매개변수 공간과 레짐 공간에서도 마찬가지입니다.
원칙 1: 다차원 응력 테스트("취성" 테스트)
금융 분야에서 과적합된 모델은 종종 "취약"합니다. 즉, 입력이나 구성이 약간 변동되면 성능이 저하됩니다. 우리는 3차원에 걸쳐 안정성을 테스트합니다.
A. 매개변수 감도 표면(손실 지형 기하학)
단지 최고의 하이퍼파라미터를 선택하는 대신 선택한 매개변수 주변의 성능 표면 모양을 분석합니다.
개념: 손실 환경의 "급격한 최소"에 위치한 모델은 과적합됩니다. 데이터 분포가 조금만 바뀌면 데이터가 가파른 벽 위로 올라가 오류율이 폭발적으로 높아집니다. "평평한 최소값"의 모델은 견고합니다.
메커니즘(국소 민감도 분석):
- 최적의 훈련된 모델 구성을 사용합니다. C.
- 중요한 매개변수(예: 전환 창 크기, EMA 평활화 붕괴, 정규화 강도 람다)의 약간의 변동(±5%)을 나타내는 C 주위의 n차원 초구를 정의합니다.
- 이 하이퍼스피어 내에서 무작위 포인트를 샘플링하여 500개 이상의 백테스트를 실행합니다.
테스트: 성능 지표 표면의 헤세 고유값을 계산합니다.
합격 기준: 표면은 매끄럽고 상대적으로 평평해야 합니다. 최대 고유값이 너무 높으면(매우 가파른 곡률 또는 "건초 더미 속의 바늘" 솔루션을 나타냄) 모델이 실패합니다.
B. 입력 데이터 교란(적대적 견고성)
과적합 모델은 예측을 위해 매우 구체적이고 미세한 기능 조합에 의존하는 경우가 많습니다.
개념: 입력 가격에 눈에 띄지 않는 노이즈를 추가하면 모델의 거래 신호가 "적극 매수"에서 "적극 매도"로 바뀌는 경우 모델은 구조적 신호가 아닌 노이즈에 반응하는 것입니다.
메커니즘(가우스 잡음 주입):
- 실제 과거 특징 데이터 X를 가져옵니다.
- 잡음 크기가 평균 매수-매도 스프레드(하위 마이크로구조 잡음)보다 작아야 한다는 점에서 교란된 데이터를 생성합니다.
- 모델 예측 f(X) 대 f(X')를 비교합니다.
합격 기준: 깨끗한 데이터와 잡음이 있는 데이터에 대한 예측 간의 상관 관계는 0.95보다 커야 합니다. 모델의 출력은 서브틱 노이즈에 대해 안정적이어야 합니다.
C. 합성 경로 생성(GAN/부트스트랩)
내역은 하나의 샘플 경로일 뿐입니다. 과적합은 종종 특정 역사적 사건 순서에 대해 최적화하는 것입니다.
메커니즘(조합 제거 교차 검증 - CPCV):
Divide history into $N$ granular blocks (e.g., weeks).
이러한 블록을 무작위 순서로 재결합하여 수천 개의 합성 기록 경로를 생성합니다(유출을 방지하기 위해 경계에서 데이터를 제거하는 동안).
테스트: 수천 개의 합성 기록에 대해 모델을 실행합니다.
합격 기준: 합성 경로 전반의 샤프 비율 분포에는 큰 왼쪽 꼬리가 있어서는 안 됩니다. 우리는 확률적 샤프 비율(PSR). 모델이 실제 과거 경로에서만 작동하지만 재결합된 경로의 90%에서 실패하면 운이 좋아서 과적합된 것입니다.
원칙 2: 시장 국면 기반 행동 감사("설명 가능성" 테스트)
거래에서 "설명 가능성"은 "P/E 비율이 중요하다"는 것을 확인하기 위해 SHAP 값을 살펴보는 것을 의미하지 않습니다. 이는 모델의 행동이 다음과 같아야 함을 의미합니다. 유사한 경제 상황에서 예측 가능하게 일관됨. 그렇지 않다면 허위 컨텍스트를 학습한 것입니다.
A. 시장 국면 클러스터링 일관성 검사
전제 조건: 파이프라인의 시장 국면 감지 모듈(이전에 확립된 WKMeans 또는 HMM 사용)은 (무작위 예시 시장 국면의 경우) 기록을 시장 국면 1(낮은 거래량 강세), 시장 국면 2(높은 거래량 평균 복귀), 시장 국면 3(유동성 위기)와 같은 클러스터로 분류했습니다.
메커니즘:
동일한 클러스터에 속하는 분리된 기간을 식별합니다(예: 2014년 2분기와 2019년 1분기가 모두 시장 국면 1일 수 있음).
서로 다르지만 스타일적으로 유사한 기간에 대해 모델의 성능 지표(승률, 평균 이익/거래, 보유 기간)를 개별적으로 평가합니다.
테스트(행동 변화): 서로 다른 시간에 걸쳐 동일한 시장 국면 클러스터 내의 주요 지표의 분산을 계산합니다.
합격 기준: 내부 변동이 낮습니다. 모델이 2014년 강세장에서 60%의 승률을 보였지만 2019년 강세장에서 45%의 승률을 기록했다면 해당 모델은 "강세장"의 일반적인 개념이 아니라 2014년의 특정 특성에 과적합된 것입니다.
B. 변동성 분포 스트레스 테스트
강력한 모델은 시장 변동성과 관련하여 일관된 동작을 보여야 합니다.
메커니즘:
버킷 과거 데이터를 변동성 십분위수로 표시합니다(최하위 10% 실현 변동성부터 최고 10%까지).
각 십분위수 내에서 모델의 평균 총 레버리지 및 매출액을 계산합니다.
테스트(행동 일관성):
기대 1: 변동성이 가장 높은 십분위로 증가함에 따라 모델 레버리지는 일반적으로 감소해야 합니다(또는 최소한 그대로 유지되어야 합니다). 엄청난 변동성이 급증하는 동안 레버리지를 높이는 모델은 훈련에서 몇 가지 행운의 특이치 이벤트에 과적합될 가능성이 높습니다.
예상 2("패닉" 검사): 변동성이 가장 높은 백분위수(위기)에서 모델의 거래 빈도가 폭발합니까? 과적합된 모델은 인식하지 못하는 잡음 환경에서 종종 "스래싱"(빠른 구매/판매)을 합니다.
합격 기준: 시장 변동성 버킷과 모델 위험 감수 행동 간의 단조로운(또는 논리적으로 설명 가능한) 관계입니다.
VII. AI 알고리즘 순서 실행
사용자에게 AI 기반(DL/DRL) 알고리즘 실행을 제공하여 슬리피지 및 거래 비용을 줄이고 실행 효율성 및 자동화를 높이는 것은 AlphaNet의 주요 기능 중 하나입니다.
많은 퀀트들은 알고리즘 실행을 생각할 때 먼저 많은 대형 은행들이 수년 동안 안정적으로 사용해 온 수학적 또는 통계적 실행 모델을 생각합니다. 이 분석에서는 전통적인 "일정 기반"(확률적 제어) 실행(Almgren-Chriss 알고리즘이 널리 사용됨)에서 "적응형" 실행(심층 학습/DRL)으로의 전환과 이를 지원하는 데 필요한 인프라에 대해 자세히 설명합니다.
1. 딥러닝 실행이 Almgren-Chriss(AC)보다 우수한 이유
실행 방법에 대한 자세한 비교는 다음을 참조하세요. 동적 TWAP 최적화: Almgren-Chriss 확률적 제어와 강화 학습.
전통적인 Almgren-Chriss(2000) 모델은 거래를 볼록한 최적화 문제로 취급합니다. 즉, 위험 회피 페널티(변동성)에 따라 비용(시장 영향)을 최소화합니다. 우아하지만 DL/DRL이 해결하는 세 가지 구체적인 이유 때문에 많은 현대 시장에서는 실패합니다.
A. 비선형성 및 교차 영향("현실주의" 격차)
기존(AC): 시장 영향은 다음과 같다고 가정합니다. 선형 (매도량의 2배, 가격의 2배 이동) 및 임시/영구 분할은 일정합니다. 자산을 분리하여 봅니다.
딥 러닝: 시장은 비선형적입니다. "시장 영향 표면"은 유동성 깊이에 따라 변경됩니다.
DL 이점: 신경망은 주문서가 "비뚤어진 입찰 측"일 때 100랏을 판매하는 것은 아무런 영향을 미치지 않지만 책이 "평탄"할 때 100랏을 판매하면 충돌이 발생한다는 것을 학습할 수 있습니다.
교차 영향: DL 모델(특히 그래프 신경망 또는 Transformer)은 상관된 자산(예: "BTC가 덤핑 중이므로 ETH 유동성이 50ms 내에 사라질 것입니다")을 보고 영향이 대상 자산에 도달하기 전에 실행을 조정할 수 있습니다.
B. 미세구조 인식("알파" 격차)
기존(AC): AC의 기존 구현은 "블라인드"이거나 LOB(Limit Order Book) 마이크로 구조로 제한됩니다. 변동성과 시간에만 관심이 있습니다. 스프레드가 1틱인지 10틱인지에 관계없이 일정에 따라 실행됩니다.
딥 러닝: 용도 레벨 2-3 데이터 (주문 대기열)를 입력으로 사용합니다.
- 스마트 TWAP: 매분 맹목적으로 구매하는 대신 DL-TWAP 에이전트는 주문장 불균형(OBI). 매도 압력이 크면 일시 중지됩니다(하락을 기다립니다). 매수 압력이 있으면 공격적으로 입찰에 참여합니다. "공격적인 테이크"(스프레드 지불)보다는 "패시브 필"(스프레드 획득)을 목표로 합니다.
C. 시장 국면에 대한 적응성("경직성" 격차)
기존(AC): "위험 회피"와 같은 매개변수는 거래가 시작되기 전에 거래자가 설정한 정적 상수입니다.
심층 강화 학습(DRL): 에이전트는 현재 상태를 작업에 매핑하는 정책 P를 학습합니다.
- 시나리오: 거래 중간에 변동성이 10%에서 50%로 급등하면 AC는 사전 계산된 곡선을 계속 유지하여 잠재적으로 도살당할 수 있습니다. DRL 에이전트는 "고변동성" 상태를 즉시 인식하고 동작을 전환(예: 재고 위험을 줄이기 위해 더 빠르게 덤핑)하여 숙련된 인간 거래자의 동작을 동적으로 모방합니다.
2. DL 실행을 위한 컴퓨팅 및 시스템 아키텍처
Alpha Generation 파이프라인(오프라인으로 실행됨)과 달리 Execution Algos는 다음에서 실행되어야 합니다. 실시간 (온라인 추론).
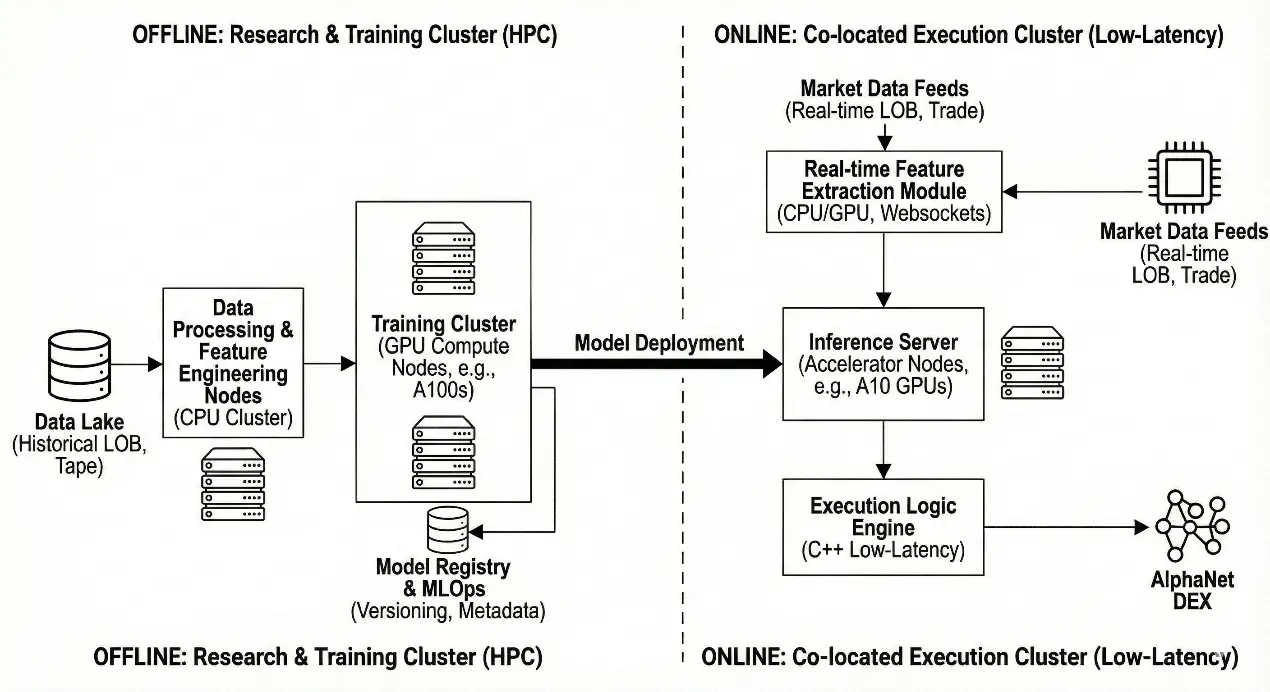
A. 교육 환경(오프라인)
실제 시장에서는 DRL 에이전트를 교육할 수 없습니다(너무 비쌉니다). 당신은 고성능 시뮬레이터.
컴퓨팅: 대규모 CPU 클러스터(예: 256개 이상의 코어).
엔진: ABIDES와 같은 다중 에이전트 시뮬레이터 또는 "시뮬레이션된 영향"을 갖춘 기록 재생 엔진입니다.
프로세스: DRL 에이전트는 기록 LOB 데이터를 사용하여 시뮬레이터에 대해 수백만 개의 "트레이딩 게임"을 실행합니다. 최소화하는 법을 배웁니다. 구현 부족(IS).
B. 추론 엔진(온라인/공동 위치)
훈련된 모델이 있는 곳입니다. 마이크로초 또는 한 자리 밀리초 단위로 "매수/판매/보유"를 결정해야 합니다.
하드웨어:
추론 서버: 교환 데이터 센터(예: NY4, LD4)에 공동 위치합니다.
가속기: 맞춤형 신경망 IP 블록을 실행하는 NVIDIA T4 또는 A10 GPU(INT8 추론에 최적화됨) 또는 FPGA(Xilinx Alveo).
소프트웨어 스택:
TensorRT / ONNX 런타임: 밀리초 미만의 추론을 위해 훈련된 PyTorch 모델을 최적화합니다.
C++/Go 래퍼: 핵심 실행 논리는 C++입니다. "결정"에 대해서만 Python/TensorRT 모델을 호출한 다음 바이너리 FIX/OUCH 프로토콜을 통해 주문을 실행합니다.
C. 데이터 수집(연료)
입력: 전체 깊이 LOB(레벨 2), 트레이드 테이프 및 파생 기능.
기능 엔지니어링: 즉시(메모리 내에서) 발생해야 합니다. 데이터베이스를 쿼리할 수 없습니다. FPGA 또는 CPU는 모델에 공급하기 위해 텐서 상태(예: [Last_50_Ticks, Volume_Profile, Current_Inventory])를 구성합니다.
3. 비교: 기존 알고리즘과 딥 러닝 알고리즘
다음 표는 기존 접근 방식(Almgren-Chriss/VWAP)과 최신 DL/DRL 등가물을 대조합니다.
| 기능 | 전통(Almgren-Chriss / 정적 VWAP) | 딥 러닝/DRL 활성화 |
|---|---|---|
| 수학적 기초 | 폐쇄형 볼록 최적화(미적분학). | 마르코프 결정 프로세스(MDP)/심층 신경망. |
| 입력 데이터 | 가격, 변동성, 거래량, 시간. | 전체 LOB(L2/L3), 주문 흐름, 미세구조 특징, 잠재 상태. |
| 시장 영향 | 가정 선형 또는 제곱근 법칙. 끊임없는. | 학습함 비선형 표면. 유동성 깊이에 따른 동적. |
| 일정 | 사전 결정됨 (정적 곡선). "15분마다 10% 매수하겠습니다." | 동적 정책. "가격 상승 확률 > 70%일 때 구매하겠습니다." |
| 스프레드 캡처 | 일반적으로 매수-매도 스프레드를 무시합니다(중간 지점 가정). | 활성 스프레드 캡처. 리베이트를 얻기 위해 지정가 주문을 게시하는 방법을 배웁니다. |
| 적응성 | 강성. "플래시 충돌" 또는 시장 국면 전환 중에 실패합니다. | 적응형. "독성 흐름"을 인식하고 그에 따라 정지하거나 가속합니다. |
| 컴퓨팅 비용 | 무시할 수 있습니다(계산기에서 실행할 수 있음). | 높음. 훈련 및 지연 시간이 짧은 추론 서버에는 GPU가 필요합니다. |
| 키 약점 | 예측 가능(약탈적 HFT는 VWAP 알고리즘을 "스니핑"할 수 있음). | "블랙박스" 위험(설명하기 더 어려움) 왜요? 거래를 일시 중지했습니다). |
특정 알고리즘 변형
DL-TWAP: Dynamic TWAP는 전체 거래 블록을 최소한의 비용으로 적시에 실행해야 하는 경우(짧은 기간 거래 전략에서와 같이) "타임 슬라이싱"(1분마다 구매) 대신 "스마트 페이싱"을 수행합니다. Micro-Price(거래량 가중 중간 가격)를 추적합니다. 마이크로 가격이 중간 가격(압력을 나타냄)에서 크게 벗어나면 더 나은 채우기를 위해 슬라이스 타이밍을 조정합니다. 고급 TWAP 알고리즘은 또한 유동성 기회를 감지하는 것뿐만 아니라 다음 기간의 잠재적 가격 방향을 감지하여 속도를 활용하는 적절한 단기 가격 변동 예측 모델을 갖추고 있습니다.
*DL-VWAP: 전통적인 VWAP는 "볼륨 스마일"(U자 모양)이 매일 동일하다고 가정합니다. 딥 VWAP 는 LSTM/Transformer를 사용하여 거래 첫 30분을 기준으로 오늘의 특정 거래량 곡선을 예측하여 거래량이 적은 날에 너무 많이 거래하는 함정을 피합니다. VWAP는 순수 메이커 주문, 오프로드 거래 또는 최소한의 시장 영향으로 시간에 민감하지 않은 거래 구축에 적합합니다(6시간 이상에서 며칠까지의 거래에 적합).
심층적인 구현 부족(하이브리드): 이것은 최고의 DRL 에이전트입니다. 두 가지 경쟁적인 내부 보상이 있습니다.
긴급성(TWAP와 유사): "종료 전에 거래를 완료하세요."
비용(VWAP와 유사): "가격을 이동하지 마세요." DRL 에이전트는 실시간 변동성에 따라 동적으로 가중치를 부여합니다. 시장이 조용하면 VWAP처럼 행동합니다. 시장이 붕괴되기 시작하면 "긴급 모드"로 전환하여 즉시 청산됩니다.
동작 차이 요약
DL-TWAP 는 "스텔스 요원". 가격이 오르거나 내려가는 것은 중요하지 않습니다. 유일한 임무는 눈에 띄지 않고 제 시간에 완료하는 것입니다. 여기서 딥러닝은 위장과 마이크로 타이밍에 중점을 두고 있습니다.
DL-VWAP 는 "팔로워". 그것은 군중을 흉내낸다. 군중이 거래하면 거래됩니다. 군중이 자면 잔다. 여기서 딥러닝은 군중의 행동을 예측하는 데 중점을 둡니다.
DL-하이브리드(구현 부족) 는 "트레이더". 의견이 있습니다. 위험(높은 변동성)을 감지하면 효과적으로 당황하게 됩니다. 안전함을 느끼면 참을성있게 행동합니다. 여기서 딥러닝은 불확실성 하에서의 전략적 의사결정에 초점을 맞추고 있습니다.
딥 러닝 알고리즘 실행 모델의 다양한 모델 구현에 대해 더 자세히 알아보려면 Tensor 팀과 AI Jimmy 책임자가 작성한 이 기술 문서를 참조하세요.
링크: [문서 링크]
기술 백서 끝